NVIDIA lanza el modelo básico Nemotron 3.5 Super VL Open-Weights para agentes empresariales
NVIDIA publica pesos para Nemotron 3.5 Super VL, una arquitectura multimodal de 120 mil millones de parámetros que presenta atención híbrida Mamba-2 y una ventana de contexto de token de un millón.
Se lanzan las computadoras portátiles Nvidia RTX Spark N1X con CPU Arm personalizada MediaTek y GPU Blackwell
Las revisiones de laboratorios independientes confirman que las computadoras portátiles Nvidia RTX Spark N1X incluyen una CPU Arm MediaTek de 20 núcleos personalizada y una GPU Blackwell con 128 GB de memoria unificada para rivalizar con el silicio de Apple.
Modal adopta los procesadores centrales Vera Nvidia mientras Nvidia apunta al mercado de CPU de veinte mil millones de dólares
El proveedor de infraestructura de nube de IA Modal implementa procesadores de servidor Vera Nvidia, ya que Nvidia apunta a veinte mil millones de dólares en ventas, desafiando a Intel y AMD.
Amazon lanza la versión beta pública de TorchNeuron para conectar las cargas de trabajo de PyTorch directamente con Trainium Silicon
AWS presenta la versión beta pública de TorchNeuron que conecta los modelos PyTorch directamente al silicio Trainium personalizado sin reescrituras manuales del kernel CUDA.
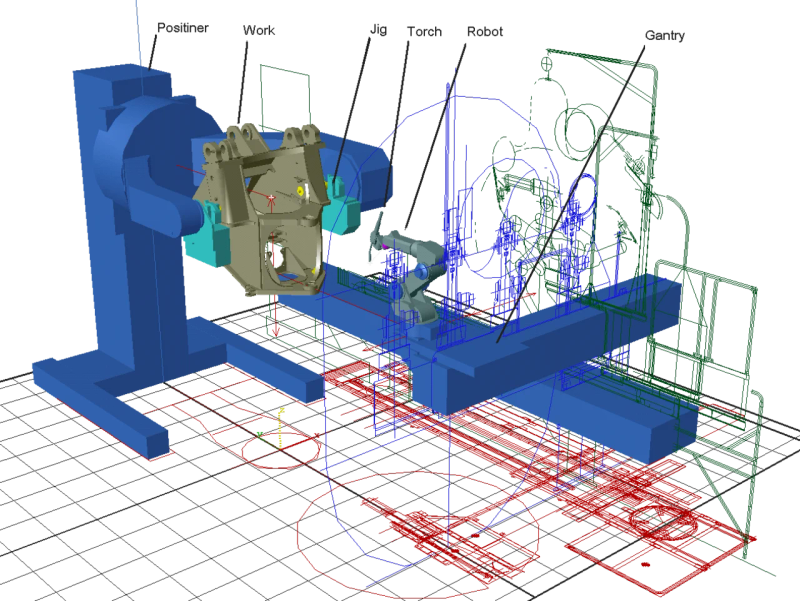
Siemens y Nvidia presentan una plataforma gemela digital de IA industrial para la automatización de fábricas
Siemens y Nvidia integran IA física y simulación de gemelos digitales Omniverse directamente en los controles de fabricación industrial, comprimiendo el reequipamiento de la línea de fábrica.
Qualcomm amplía el tiempo de ejecución del compilador abierto unificado de arquitectura múltiple para desafiar el bloqueo de CUDA
Qualcomm ofrece cadenas de herramientas de compilación multiplataforma que unen Modular y tiempos de ejecución de código abierto para ejecutar modelos de IA de alto rendimiento en chips Snapdragon, AMD y Nvidia.
Plataforma NVIDIA de código abierto Run:ai bajo Apache 2.0 para democratizar la programación de GPU de Kubernetes
NVIDIA lanza la plataforma de orquestación Run:ai completa bajo la licencia Apache 2.0 de código abierto, desbloqueando la segmentación de GPU fraccionaria nativa y la programación multiinquilino para Kubernetes.
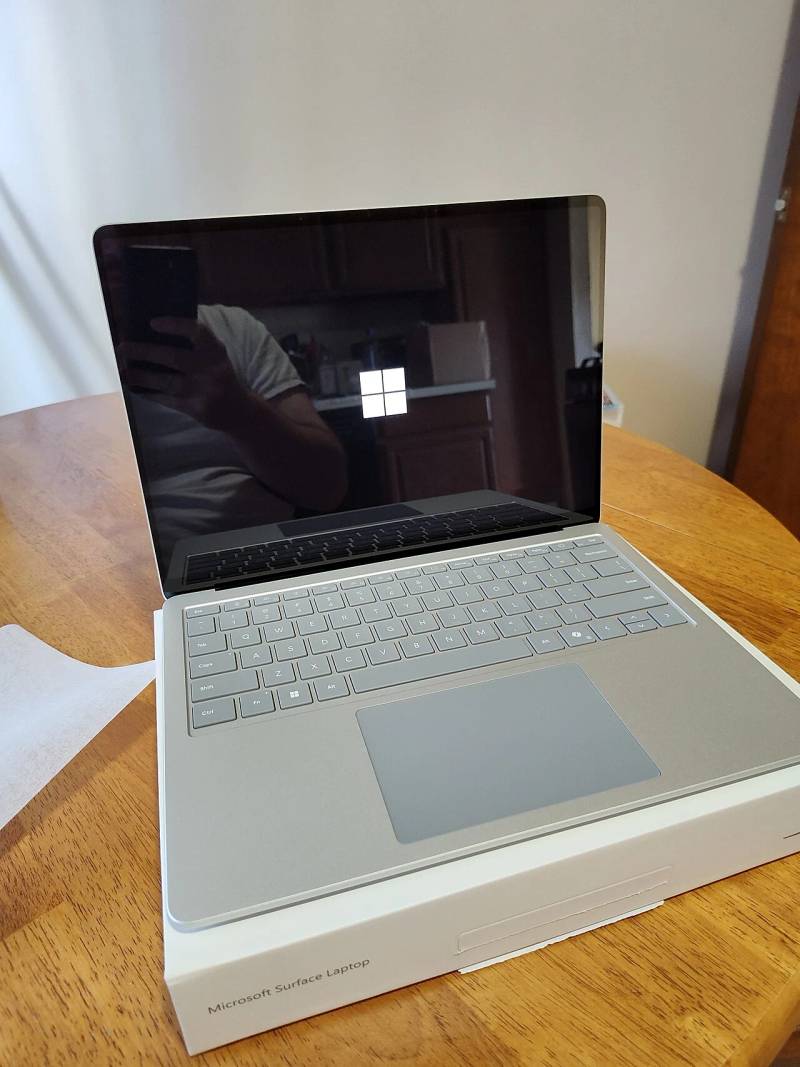
Microsoft lanza Surface Laptop Ultra con tecnología del superchip NVIDIA RTX Spark
Microsoft ha presentado Surface Laptop Ultra, partiendo del silicio móvil x86 tradicional para integrar el superchip NVIDIA RTX Spark que combina una CPU Grace de 20 núcleos con una GPU Blackwell de 6144 núcleos y 128 GB de memoria unificada.
NVIDIA Open Sources Run:ai Platform y KAI Scheduler para la orquestación de cargas de trabajo de IA
NVIDIA ha lanzado la plataforma de orquestación Run:ai completa y el programador KAI en Apache 2.0, ofreciendo fraccionamiento de GPU a nivel de hardware a los clústeres de Kubernetes.
Samsung Electronics aprueba la validación de Nvidia HBM4E para aceleradores de silicio con IA de próxima generación
Samsung Electronics obtuvo la autorización de calificación formal de Nvidia para sus módulos de memoria HBM4E de 12 capas, posicionando al gigante surcoreano de semiconductores para suministrar pilas de memoria de alta densidad para aceleradores de centros de datos de IA de próxima generación.
NVIDIA promete mil millones de dólares para infraestructura de superinteligencia de EE. UU. y presenta la arquitectura de superchip RTX Spark para PC con IA
En la Cumbre de la Edad de Oro Científica en Washington D.C., NVIDIA comprometió mil millones de dólares durante cinco años para la investigación federal de superinteligencia y presentó el superchip RTX Spark que combina el silicio Blackwell y Grace para PC con Windows AI.
Samsung proyecta una ganancia récord de 107,4 billones de wones en el tercer trimestre mientras el HBM4E de 12 capas supera la calificación de hiperescalador
Samsung Electronics emitió una histórica guía preliminar para el tercer trimestre que proyecta una ganancia operativa de 107,4 billones de wones impulsada por la demanda de memoria de IA, junto con la calificación confirmada de sus módulos HBM4E de 12 capas con Nvidia.
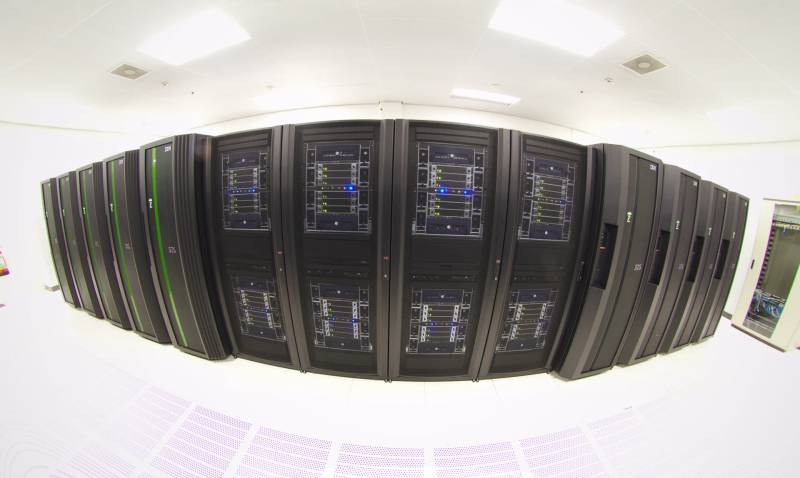
Nous Research recauda 90 millones de dólares en una ronda de la Serie A liderada por NVIDIA, Microsoft y Samsung para avanzar en los agentes de razonamiento autónomos Hermes de código abierto
El colectivo de investigación de inteligencia artificial de código abierto Nous Research recaudó 90 millones de dólares en fondos de Serie A respaldados por NVIDIA, Microsoft M12 y Samsung Next para avanzar en modelos de razonamiento autónomos descentralizados y el marco Hermes Agent.
Mistral AI lanza la arquitectura MoE granular Mistral Large 4 con 1,05 billones de parámetros y contexto a escala de billones
El laboratorio francés de IA presentó su modelo insignia de combinación de expertos de billones de parámetros, enrutando 49 mil millones de parámetros activos por token en NVIDIA Grace Blackwell para combinar inteligencia de frontera con una alta eficiencia de servicio.
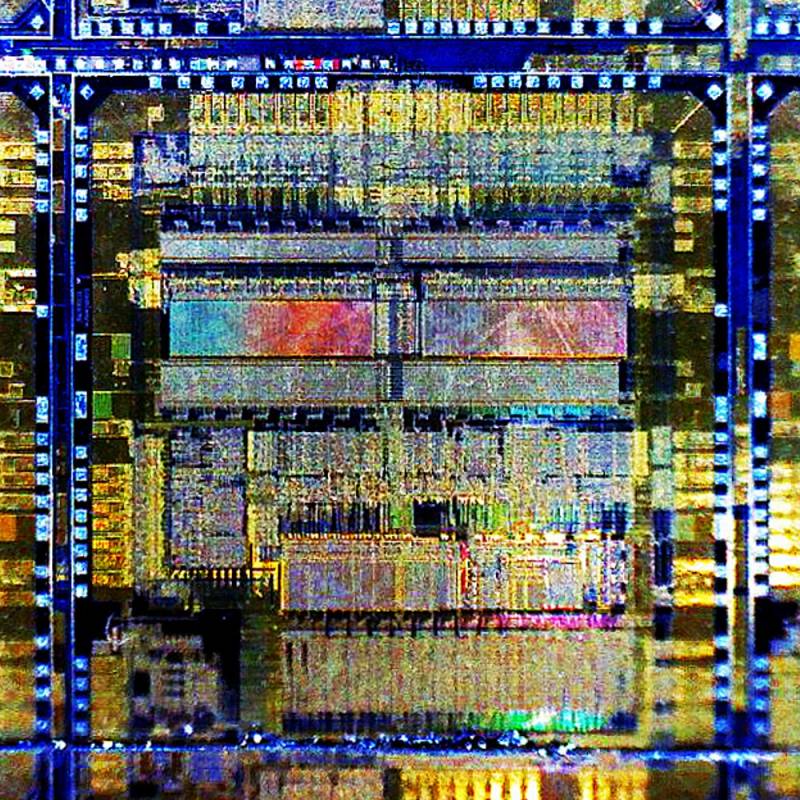
Microsoft y NVIDIA presentan Surface Laptop Ultra con tecnología RTX Spark Superchip para IA local de alta eficiencia
Presentada en San Francisco por Satya Nadella y Jensen Huang, la PC insignia de 15 pulgadas combina núcleos de CPU MediaTek Arm personalizados con gráficos NVIDIA Blackwell para ofrecer un petaflop de procesamiento neuronal en el dispositivo.
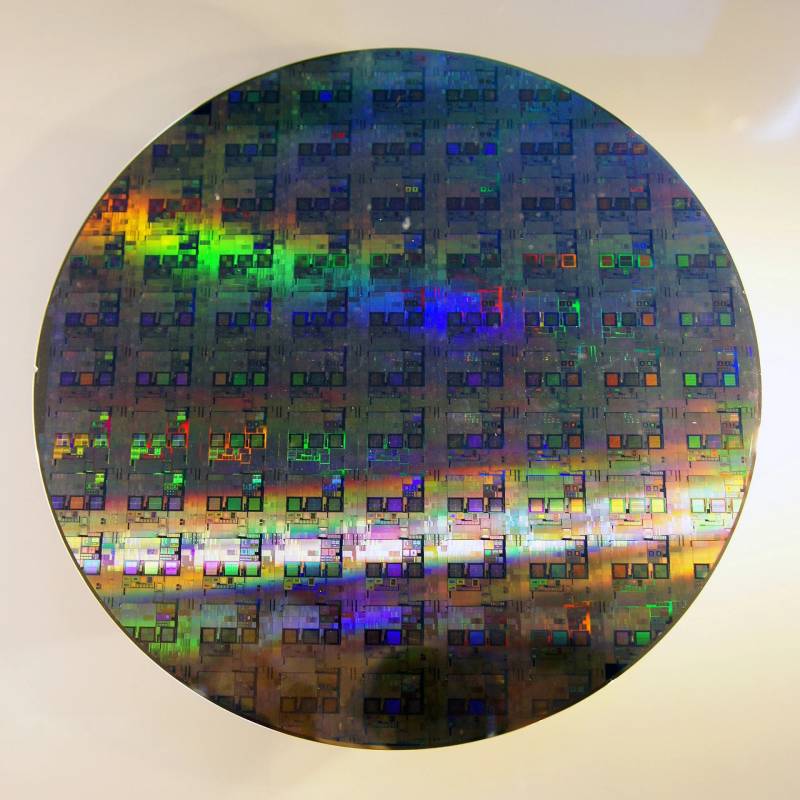
GIGABYTE presenta la supercomputadora personal TOP ATOM con memoria unificada AI de 64 GB impulsada por NVIDIA GB10 Grace Blackwell
GIGABYTE ha presentado una versión de memoria unificada de 64 GB de su supercomputadora de escritorio AI TOP ATOM, lo que hace que la aceleración local Grace Blackwell sea accesible para el desarrollo privado de modelos de IA.
NVIDIA presenta la plataforma Open Agent Safety y Sentry Hardware Watchdog para proteger la IA empresarial autónoma
NVIDIA ha lanzado Open Agent Safety Platform junto con NVIDIA Sentry, un dispositivo de vigilancia de hardware fuera de banda que se ejecuta en unidades de procesamiento de datos BlueField y que impone límites de comportamiento en tiempo real para enjambres de agentes de IA empresariales autónomos.
Nvidia lanza una plataforma de seguridad de agentes abiertos con OpenShell y BlueField-4 Sentry para prevenir la IA autónoma no autorizada
Nvidia ha presentado un entorno de pruebas de tiempo de ejecución de código abierto y una arquitectura de vigilancia aislada por hardware diseñada para interceptar comportamientos errantes de agentes autónomos de IA antes de que los procesos comprometan las redes empresariales.
NVIDIA lanza la plataforma Open Agent Safety con OpenShell Runtime y BlueField-4 Sentry Watchdog
NVIDIA presentó oficialmente la Open Agent Safety Platform, que combina la zona de pruebas del kernel OpenShell de código abierto con telemetría DPU BlueField-4 fuera de banda para poner en cuarentena a agentes autónomos no autorizados en milisegundos.
NVIDIA presenta el superchip RTX Spark y el enrutador de IA local PAIR de código abierto para potenciar la computación agente en el dispositivo
En IFA Berlín, NVIDIA presentó el superchip personal RTX Spark que integra una CPU Grace de 20 núcleos con una GPU Blackwell junto con PAIR, un enrutador de código abierto que distribuye inferencia local de IA.
NVIDIA NVLabs presenta cadenas de herramientas nativas CUDA Rust que brindan seguridad de la memoria directamente a la programación del kernel de GPU
NVIDIA NVLabs presentó cuda-oxide y cutile-rs, lanzando cadenas de herramientas de compilación de código abierto que permiten a los desarrolladores escribir núcleos de GPU de alto rendimiento en Rust con memoria segura sin envoltorios de funciones externas.
Mitsubishi Electric presenta la arquitectura de energía Chip to Grid DSX2 para los centros de supercomputación NVIDIA Vera Rubin
Mitsubishi Electric anunció su arquitectura de referencia DSX2 Chip-to-Grid, que sincroniza subestaciones eléctricas de servicios públicos y refrigeración líquida de microsegundos para centros de datos NVIDIA Vera Rubin NVL72.
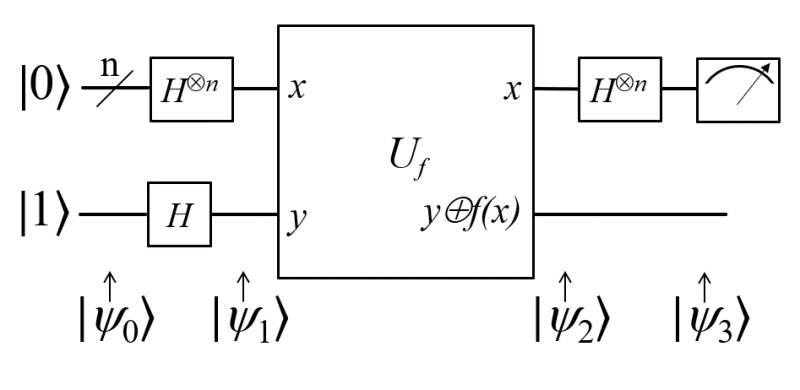
Marco OpenQARP de código abierto de Fujitsu para estandarizar el desarrollo de aplicaciones cuánticas modulares
Con licencia Apache 2.0, el marco modular de C++ y Python proporciona más de 100 algoritmos cuánticos y primitivas de circuitos compatibles con NVIDIA CUDA-Q y simuladores de supercomputadoras de alto rendimiento.
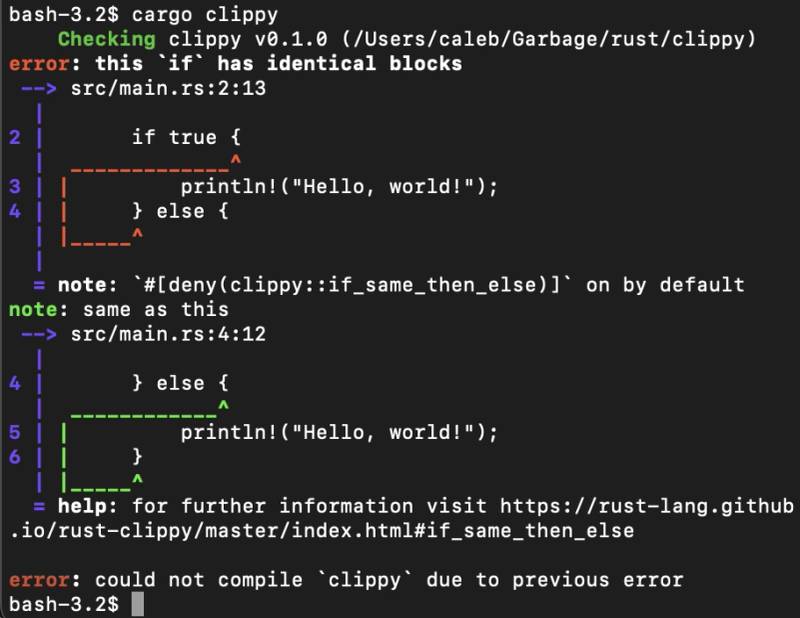
Nvidia anuncia CUDA Rust para permitir la compilación nativa del kernel de GPU con estricta seguridad de la memoria en tiempo de compilación
La nueva interfaz oficial del compilador permite a los ingenieros de sistemas escribir sombreadores informáticos de alto rendimiento y núcleos tensoriales distribuidos directamente en Rust sin punteros C++ no administrados.