NVIDIA veröffentlicht Nemotron 3.5 Super VL Open-Weights Foundation Model für Enterprise Agents
NVIDIA veröffentlicht Gewichte für Nemotron 3.5 Super VL, eine multimodale Architektur mit 120 Milliarden Parametern, hybrider Mamba-2-Aufmerksamkeit und einem Kontextfenster mit einer Million Token.
Einführung der Nvidia RTX Spark N1X-Laptops mit benutzerdefinierter MediaTek-Arm-CPU und Blackwell-GPU
Unabhängige Labortests bestätigen, dass die Nvidia RTX Spark N1X-Laptops mit einer maßgeschneiderten 20-Core-Arm-CPU MediaTek und einer Blackwell-GPU mit 128 GB einheitlichem Speicher ausgestattet sind, um mit Apple-Silizium mithalten zu können.
Modal übernimmt die Vera-Zentralprozessoren Nvidia, während Nvidia auf den 20-Milliarden-Dollar-CPU-Markt abzielt
Der KI-Cloud-Infrastrukturanbieter Modal setzt Nvidia Vera-Serverprozessoren ein, während Nvidia einen Umsatz von 20 Milliarden US-Dollar anstrebt und damit Intel und AMD herausfordert.
Amazon startet die öffentliche Betaversion von TorchNeuron, um PyTorch-Workloads direkt mit Trainium Silicon zu verbinden
AWS stellt die öffentliche Betaversion von TorchNeuron vor, die PyTorch-Modelle direkt mit benutzerdefiniertem Trainium-Silizium verbindet, ohne dass der CUDA-Kernel manuell neu geschrieben werden muss.
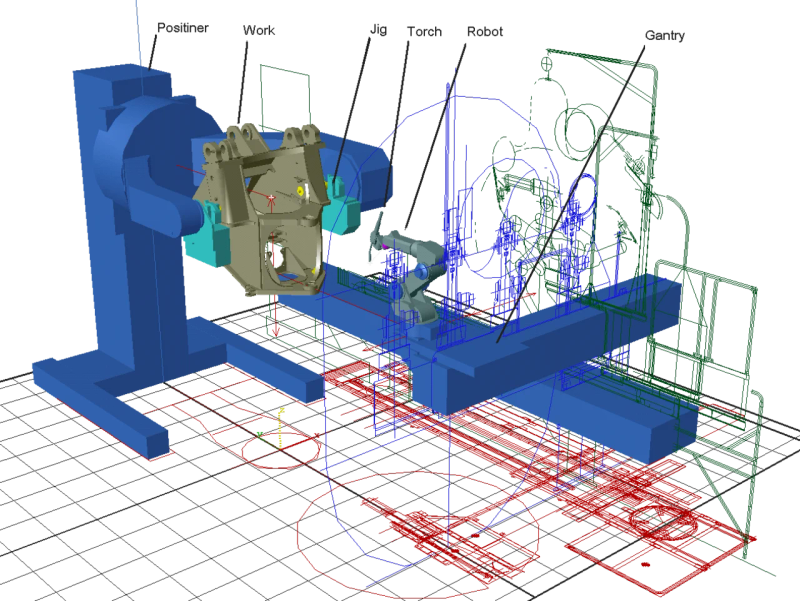
Siemens und Nvidia stellen industrielle KI-Digital-Twin-Plattform für die Fabrikautomation vor
Siemens und Nvidia integrieren physische KI und Omniverse-Digital-Twin-Simulation direkt in industrielle Fertigungssteuerungen und verkürzen so die Umrüstung der Fabriklinien.
Qualcomm erweitert die einheitliche Multi-Architektur-Open-Compiler-Laufzeit, um CUDA-Lock-In zu überwinden
Qualcomm liefert plattformübergreifende Compiler-Toolchains, die Modular und Open-Source-Laufzeiten vereinen, um leistungsstarke KI-Modelle auf Snapdragon-, AMD- und Nvidia-Chips auszuführen.
NVIDIA Open-Source-Plattform Run:ai unter Apache 2.0 zur Demokratisierung der Kubernetes-GPU-Planung
NVIDIA veröffentlicht die komplette Run:ai-Orchestrierungsplattform unter der Open-Source-Apache-2.0-Lizenz und schaltet natives fraktioniertes GPU-Slicing und Multi-Tenant-Planung für Kubernetes frei.
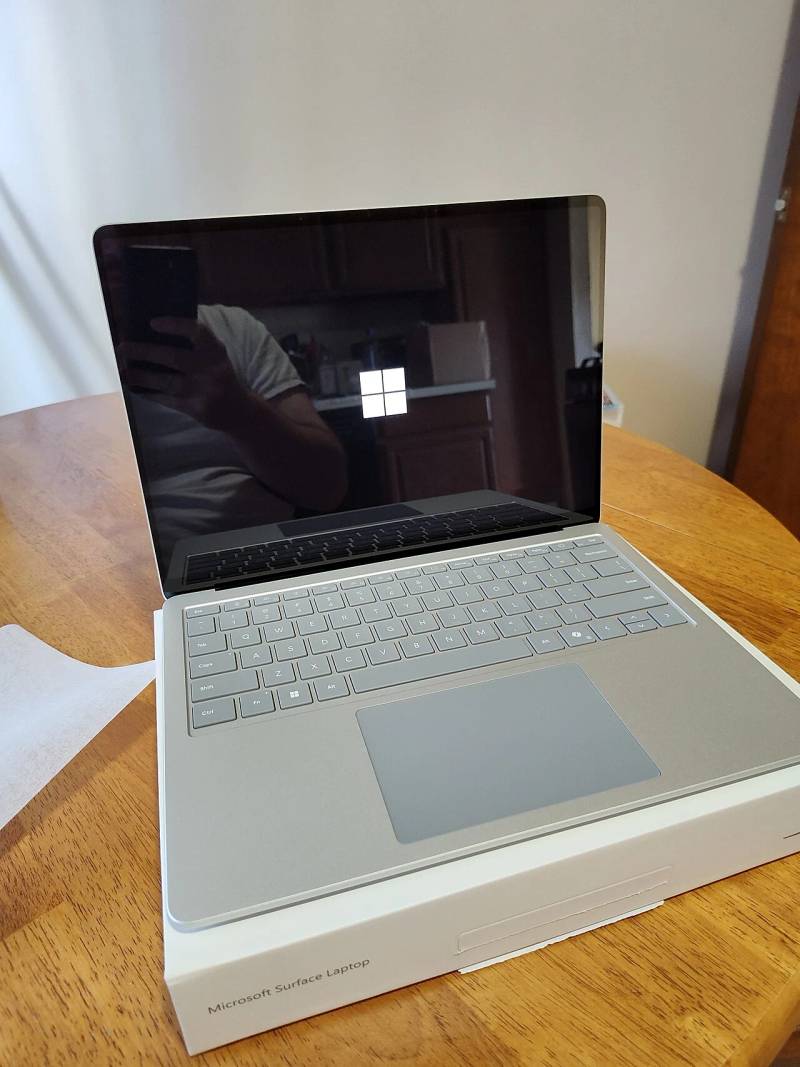
Microsoft bringt Surface Laptop Ultra mit NVIDIA RTX Spark Superchip auf den Markt
Microsoft hat das Surface Laptop Ultra vorgestellt und dabei vom traditionellen x86-Mobilchip abgewichen und den NVIDIA RTX Spark-Superchip integriert, der eine 20-Kern-Grace-CPU mit einer 6.144-Kern-Blackwell-GPU und 128 GB einheitlichem Speicher kombiniert.
NVIDIA Open Sources Run:ai Platform und KAI Scheduler für AI Workload Orchestration
NVIDIA hat die komplette Run:ai-Orchestrierungsplattform und den KAI Scheduler unter Apache 2.0 veröffentlicht und liefert GPU-Fraktionierung auf Hardwareebene für Kubernetes-Cluster.
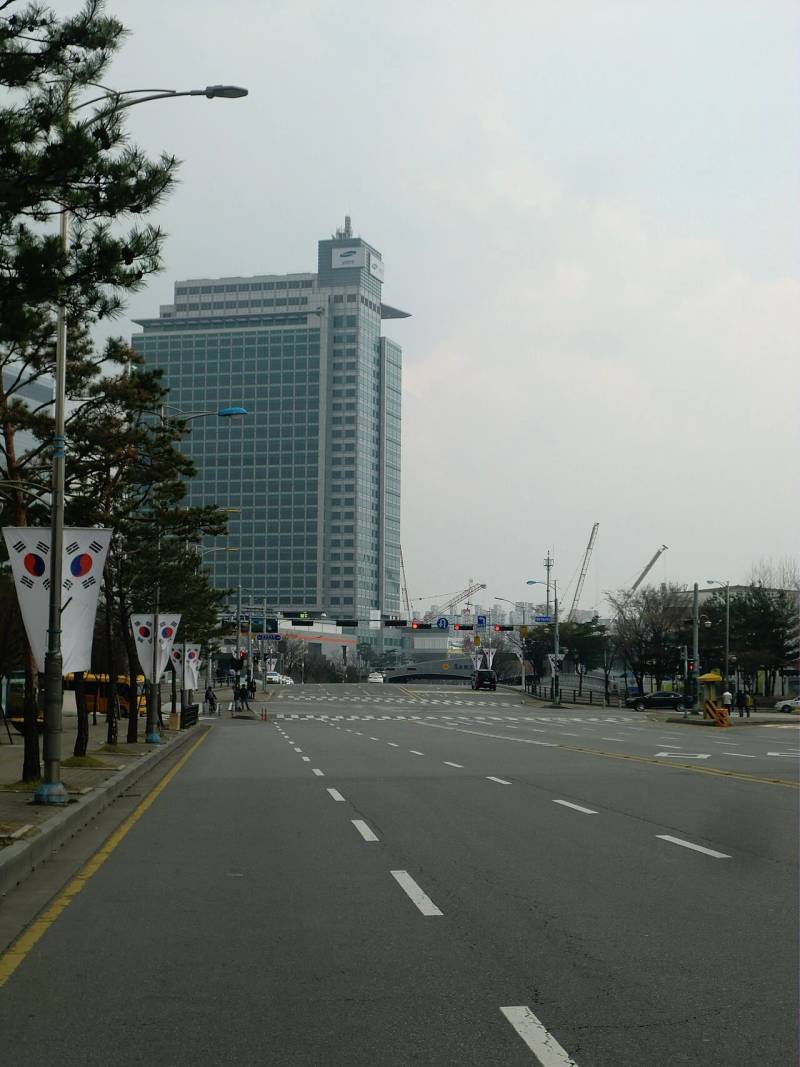
Samsung Electronics besteht Nvidia HBM4E-Validierung für KI-Siliziumbeschleuniger der nächsten Generation
Samsung Electronics hat von Nvidia die formelle Qualifikationsfreigabe für seine 12-schichtigen HBM4E-Speichermodule erhalten und positioniert damit den südkoreanischen Halbleiterriesen als Lieferant von hochdichten Speicherstacks für KI-Rechenzentrumsbeschleuniger der nächsten Generation.
NVIDIA verspricht 1 Milliarde US-Dollar für US-amerikanische Super-Intelligence-Infrastruktur und stellt RTX Spark Superchip-Architektur für KI-PCs vor
Auf dem Science Golden Age Summit in Washington D.C. hat NVIDIA über einen Zeitraum von fünf Jahren 1 Milliarde US-Dollar für die Superintelligenzforschung des Bundes bereitgestellt und den RTX Spark-Superchip vorgestellt, der Blackwell- und Grace-Silizium für Windows-KI-PCs kombiniert.
Samsung prognostiziert einen Rekordgewinn von 107,4 Billionen Won im dritten Quartal, da 12-Layer-HBM4E die Hyperscaler-Qualifikation besteht
Samsung Electronics gab eine historische vorläufige Prognose für das dritte Quartal heraus, die einen Betriebsgewinn von 107,4 Billionen Won prognostiziert, der durch die Nachfrage nach KI-Speicher angekurbelt wird, und bestätigte gleichzeitig die Qualifizierung seiner 12-Layer-HBM4E-Module mit Nvidia.
Nous Research sammelt 90 Millionen US-Dollar in einer von NVIDIA, Microsoft und Samsung angeführten Serie-A-Runde ein, um Open-Source-Hermes-Agenten für autonomes Denken voranzutreiben
Das Open-Source-Forschungskollektiv für künstliche Intelligenz Nous Research hat im Rahmen einer von NVIDIA, Microsoft M12 und Samsung Next unterstützten Serie-A-Finanzierung 90 Millionen US-Dollar gesammelt, um dezentrale autonome Argumentationsmodelle und das Hermes Agent-Framework voranzutreiben.
Mistral AI veröffentlicht Mistral Large 4 Granular MoE-Architektur mit 1,05 Billionen Parametern und Kontext im Billionen-Maßstab
Das französische KI-Labor stellte sein Flaggschiff-Expertenmodell mit Billionen Parametern vor, das 49 Milliarden aktive Parameter pro Token auf NVIDIA Grace Blackwell weiterleitet, um Grenzintelligenz mit hoher Serving-Effizienz zu kombinieren.
Microsoft und NVIDIA stellen Surface Laptop Ultra mit RTX Spark Superchip für hocheffiziente lokale KI vor
Der von Satya Nadella und Jensen Huang in San Francisco vorgestellte Flaggschiff-15-Zoll-PC kombiniert benutzerdefinierte MediaTek Arm-CPU-Kerne mit NVIDIA Blackwell-Grafiken, um einen Petaflop neuronaler Verarbeitung auf dem Gerät zu liefern.
GIGABYTE stellt 64 GB Unified Memory AI TOP ATOM Personal Supercomputer mit NVIDIA GB10 Grace Blackwell vor
GIGABYTE hat ein 64-GB-Unified-Memory-Modell seines Desktop-Supercomputers AI TOP ATOM vorgestellt, das die lokale Grace-Blackwell-Beschleunigung für die private KI-Modellentwicklung zugänglich macht.
NVIDIA stellt Open Agent Safety Platform und Sentry Hardware Watchdog zur Sicherung autonomer Unternehmens-KI vor
NVIDIA hat die Open Agent Safety Platform zusammen mit NVIDIA Sentry veröffentlicht, einem Out-of-Band-Hardware-Watchdog, der auf BlueField-Datenverarbeitungseinheiten läuft und Echtzeit-Verhaltensgrenzen für autonome KI-Agentenschwärme in Unternehmen durchsetzt.
Nvidia führt Open Agent Safety Platform mit OpenShell und BlueField-4 Sentry ein, um betrügerische autonome KI zu verhindern
Nvidia hat eine Open-Source-Laufzeit-Sandbox und eine hardwareisolierte Watchdog-Architektur vorgestellt, die darauf ausgelegt ist, fehlerhaftes Verhalten autonomer KI-Agenten abzufangen, bevor Prozesse Unternehmensnetzwerke gefährden.
NVIDIA führt Open Agent Safety-Plattform mit OpenShell Runtime und BlueField-4 Sentry Watchdog ein
NVIDIA hat offiziell die Open Agent Safety Platform eingeführt, die die Open-Source-OpenShell-Kernel-Sandbox mit Out-of-Band-BlueField-4-DPU-Telemetrie kombiniert, um unerwünschte autonome Agenten innerhalb von Millisekunden unter Quarantäne zu stellen.
NVIDIA stellt den RTX Spark Superchip und den lokalen Open-Source-PAIR-KI-Router vor, um Agentic Computing auf dem Gerät zu betreiben
Auf der IFA Berlin stellte NVIDIA den persönlichen Superchip RTX Spark vor, der eine 20-Kern-Grace-CPU mit einer Blackwell-GPU zusammen mit PAIR, einem Open-Source-Router, der lokale KI-Inferenzen verteilt, integriert.
NVIDIA NVLabs stellt native CUDA Rust-Toolchains vor, die Speichersicherheit direkt in die GPU-Kernel-Programmierung bringen
NVIDIA NVLabs stellte cuda-oxide und cutile-rs vor und brachte Open-Source-Compiler-Toolchains auf den Markt, die es Entwicklern ermöglichen, Hochleistungs-GPU-Kernel in speichersicherem Rust ohne fremde Funktions-Wrapper zu schreiben.
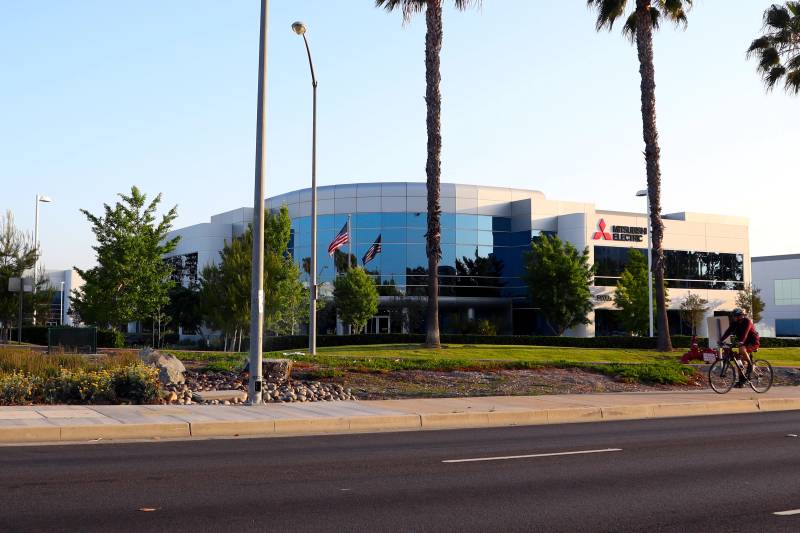
Mitsubishi Electric stellt Chip-to-Grid-DSX2-Stromversorgungsarchitektur für NVIDIA Vera Rubin Supercomputing Centers vor
Mitsubishi Electric kündigte seine DSX2 Chip-to-Grid-Referenzarchitektur an, die Umspannwerke und Mikrosekunden-Flüssigkeitskühlung für NVIDIA Vera Rubin NVL72-Rechenzentren synchronisiert.
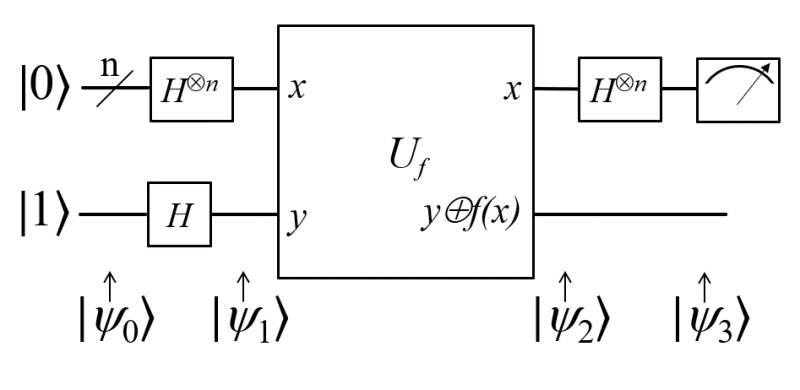
Fujitsu Open-Sources OpenQARP Framework zur Standardisierung der modularen Quantenanwendungsentwicklung
Das unter Apache 2.0 lizenzierte modulare C++- und Python-Framework bietet über 100 Quantenalgorithmen und Schaltungsprimitive, die mit NVIDIA CUDA-Q und Hochleistungs-Supercomputersimulatoren kompatibel sind.
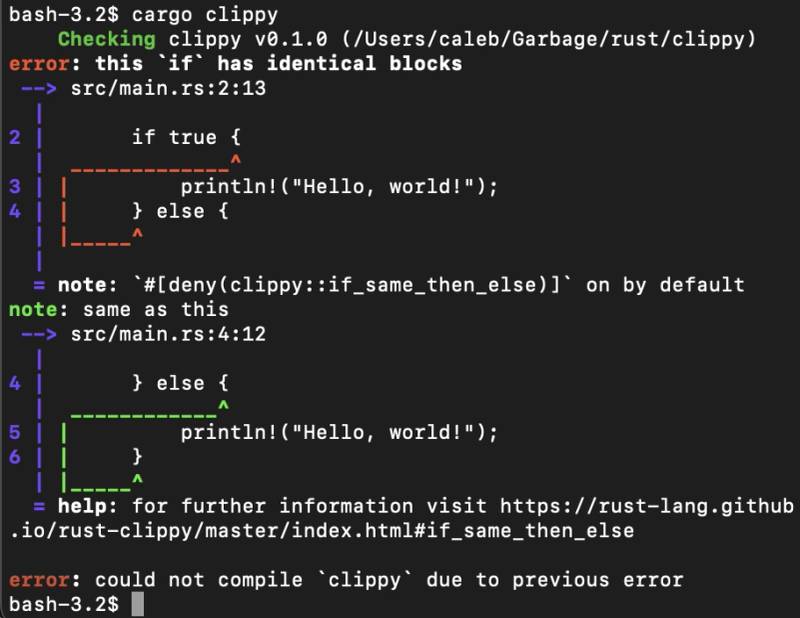
Nvidia kündigt CUDA Rust an, um die native GPU-Kernel-Kompilierung mit strikter Speichersicherheit zur Kompilierungszeit zu ermöglichen
Das neue offizielle Compiler-Frontend ermöglicht es Systemingenieuren, leistungsstarke Compute-Shader und verteilte Tensor-Kernel direkt in Rust zu schreiben, ohne nicht verwaltete C++-Zeiger.